اگر برای اجرای مدلهای هوش مصنوعی روی کامپیوتر خود از Ollama استفاده میکنید، احتمالاً از سادگی نصب مدل و شروع گفتوگو با آن راضی هستید. اما وقتی تعداد مدلها بیشتر میشود یا میخواهید عملکرد کارت گرافیک و حافظه سیستم را دقیقتر تنظیم کنید، ابزارهای پیشرفتهتری مثل llama.cpp میتوانند امکانات بیشتری در اختیارتان بگذارند.
انتخاب بین این دو ابزار فقط به سرعت پاسخگویی مدل مربوط نمیشود. نحوه مدیریت فایلها، میزان کنترل روی منابع سختافزاری و امکان آزمایش تنظیمات مختلف هم اهمیت دارند. برای اجرای هوش مصنوعی محلی، بهتر است ابزاری را انتخاب کنید که با سطح دانش فنی و شیوه استفاده شما هماهنگ باشد.
مقایسه Ollama و llama.cpp؛ کدام ابزار برای اجرای هوش مصنوعی محلی بهتر است؟
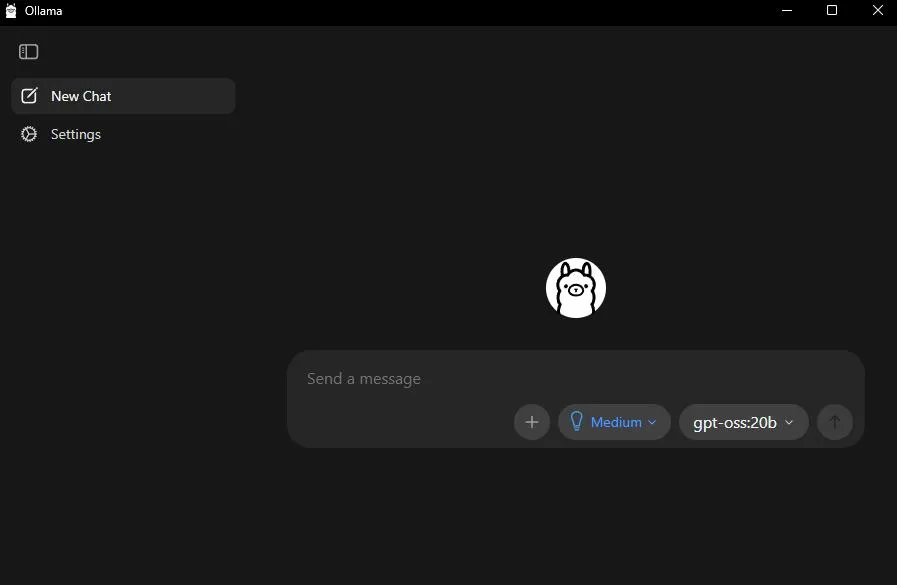
Ollama برای افرادی طراحی شده است که میخواهند بدون درگیر شدن با تنظیمات پیچیده، مدلهای هوش مصنوعی را دانلود و اجرا کنند. این ابزار فرایند راهاندازی را ساده میکند و برای شروع کار با مدلهای زبانی محلی انتخاب مناسبی است. رابط گرافیکی آن نیز کار با مدلها را برای کاربران تازهکار آسانتر میکند.
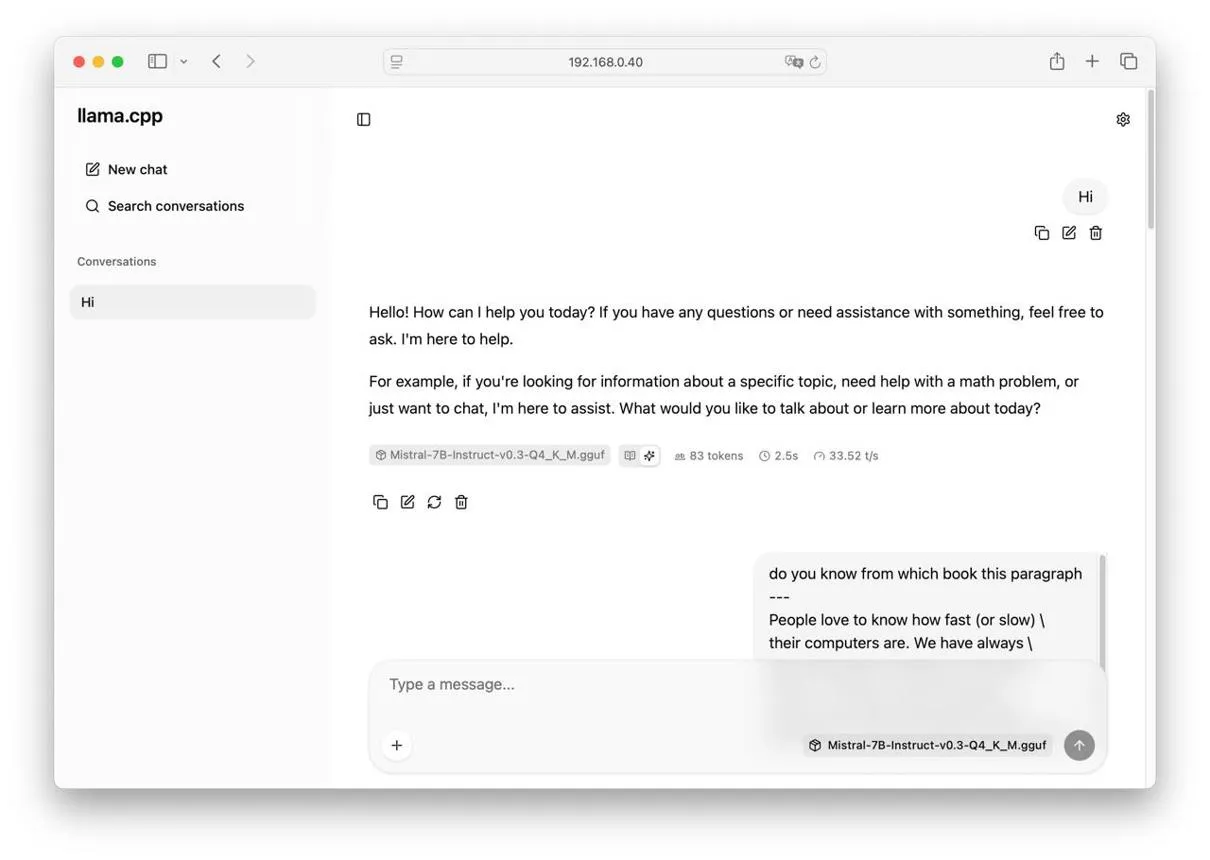
در مقابل، llama.cpp ابزار انعطافپذیرتری برای کسانی است که میخواهند جزئیات اجرای مدل را کنترل کنند. این پروژه از اجرای مدلهای کوانتیده و استفاده از پردازنده یا کارت گرافیک پشتیبانی میکند و امکان راهاندازی یک سرور محلی با رابط گفتوگو را نیز دارد.
تفاوتهای اصلی این دو ابزار را میتوان اینطور خلاصه کرد:
- سهولت استفاده: Ollama معمولاً برای شروع سریع و استفاده روزمره سادهتر است.
- کنترل سختافزار: llama.cpp گزینههای بیشتری برای تنظیم لایههای مدل روی GPU و مدیریت بخشی از محاسبات روی CPU دارد.
- مدیریت فایلها: در llama.cpp میتوانید مسیر یک مدل GGUF را مستقیماً مشخص کنید؛ بنابراین لازم نیست صرفاً برای اجرای مدل، آن را به پوشه اختصاصی ابزار دیگری منتقل کنید.
- آزمایش و ارزیابی: ابزارهای بنچمارک llama.cpp برای اندازهگیری عملکرد مدل و مقایسه تنظیمات مختلف مفید هستند.
- رابط کاربری: Ollama برای کاربرانی که به دنبال تجربهای ساده و کمدردسر هستند مناسب است؛ llama.cpp نیز رابط وب دارد، اما راهاندازی و تنظیم آن ممکن است به دانش فنی بیشتری نیاز داشته باشد.
نکته مهم این است که تفاوت سرعت میان این دو ابزار همیشه چشمگیر نیست. نسخه نرمافزار، نوع مدل، اندازه پنجره زمینه، میزان کوانتایزیشن و تنظیمات سختافزاری میتوانند نتیجه را تغییر دهند. بنابراین، صرفاً به نام ابزار یا نتایج منتشرشده برای یک کامپیوتر دیگر تکیه نکنید.
اجرای مدل هوش مصنوعی بزرگتر از حافظه کارت گرافیک با llama.cpp
یکی از مزیتهای llama.cpp امکان تنظیم دقیقتر محل اجرای بخشهای مختلف مدل است. این موضوع برای کاربرانی اهمیت دارد که کارت گرافیک آنها حافظه محدودی دارد، اما میخواهند مدلهای بزرگتری را اجرا کنند.
به عنوان مثال، مدلی با حجم فایل ۱۷٫۷ گیگابایت بهراحتی بهطور کامل در کارت گرافیکی با ۱۶ گیگابایت حافظه VRAM جا نمیشود. با این حال، اندازه فایل مدل بهتنهایی میزان حافظه موردنیاز هنگام اجرا را مشخص نمیکند؛ حافظه لازم به نوع کوانتایزیشن، اندازه پنجره زمینه، حافظه موقت و تنظیمات اجرای مدل نیز وابسته است.
در بعضی مدلها، از جمله مدلهای مبتنی بر معماری Mixture of Experts یا MoE، فقط بخشی از شبکه در پردازش هر توکن فعال میشود. llama.cpp میتواند با تنظیم محل نگهداری وزنهای کارشناسان مدل، بخشی از آنها را در حافظه رم سیستم نگه دارد و بخشهای دیگر را روی کارت گرافیک اجرا کند. این روش ممکن است استفاده از مدلهای بزرگتر را امکانپذیر کند، اما نتیجه به پهنای باند حافظه، توان پردازنده و سرعت ارتباط میان رم و GPU بستگی دارد.
برای تنظیم این رفتار در نسخههای سازگار llama.cpp، گزینه --n-cpu-moe قابل استفاده است. این گزینه تعداد لایههایی را تعیین میکند که وزنهای بخش کارشناسان آنها در حافظه CPU نگهداری میشوند. برای کنترل تعداد لایههای منتقلشده به کارت گرافیک نیز گزینه --n-gpu-layers وجود دارد.
در یک آزمایش مشخص با کارت گرافیک انویدیا RTX 4070 Ti Super و مدل Qwen3.6-35B-A3B، سرعت تولید توکن با تنظیم پیشفرض Ollama حدود ۷۷ توکن بر ثانیه و با تنظیم پیشفرض llama.cpp حدود ۷۵ توکن بر ثانیه گزارش شده بود. با تنظیم هشت لایه برای نگهداری وزنهای کارشناسان در رم، سرعت llama.cpp به حدود ۸۱ توکن بر ثانیه رسید.
این اعداد نتیجه یک پیکربندی خاص هستند و نباید آنها را به همه مدلها و سیستمها تعمیم داد. حتی ممکن است تنظیمی که سرعت تولید توکن را افزایش میدهد، مصرف رم یا زمان پردازش ورودی را بیشتر کند. بهترین تنظیم برای سیستم شما باید با آزمایش عملی مشخص شود.
بنچمارک هوش مصنوعی و مدیریت مدلهای GGUF در llama.cpp
یکی از دلایل انتخاب llama.cpp، امکان بررسی دقیقتر عملکرد مدلها است. هنگام اجرای یک مدل زبانی، سرعت تولید پاسخ تنها معیار مهم نیست؛ زمان پردازش ورودی، میزان حافظه مصرفی و پایداری عملکرد نیز اهمیت دارند.
برای مثال، ممکن است اجرای نخست یک مدل کندتر از اجراهای بعدی باشد؛ زیرا بارگذاری وزنها و آمادهسازی حافظه هنوز کامل نشده است. اگر فقط یک بار سرعت را اندازهگیری کنید، ممکن است درباره عملکرد واقعی مدل نتیجه اشتباهی بگیرید.
ابزار llama-bench برای بنچمارک هوش مصنوعی در llama.cpp به کار میرود و میتواند زمان پردازش ورودی و تولید توکن را جداگانه اندازهگیری کند. برای مقایسه معتبر، بهتر است هر مدل را چند بار با تنظیمات یکسان آزمایش کنید و نتایج را در شرایط مشابه بسنجید.
مزیت دیگر llama.cpp این است که میتوانید مسیر فایل مدل GGUF را مستقیماً مشخص کنید. این موضوع هنگام آزمایش چند مدل مفید است؛ چون جابهجایی یا نگهداری نسخههای متعدد در پوشههای اختصاصی میتواند فضای ذخیرهسازی زیادی مصرف کند.
در Ollama نیز میتوان مدلها را مدیریت کرد، اما وارد کردن برخی فایلهای موجود ممکن است به تنظیم فایل Modelfile و اجرای فرمانهای مربوط به ساخت مدل نیاز داشته باشد. این فرایند برای کاربران تازهکار قابل انجام است، ولی هنگام آزمایش تعداد زیادی مدل میتواند کار اضافی ایجاد کند.
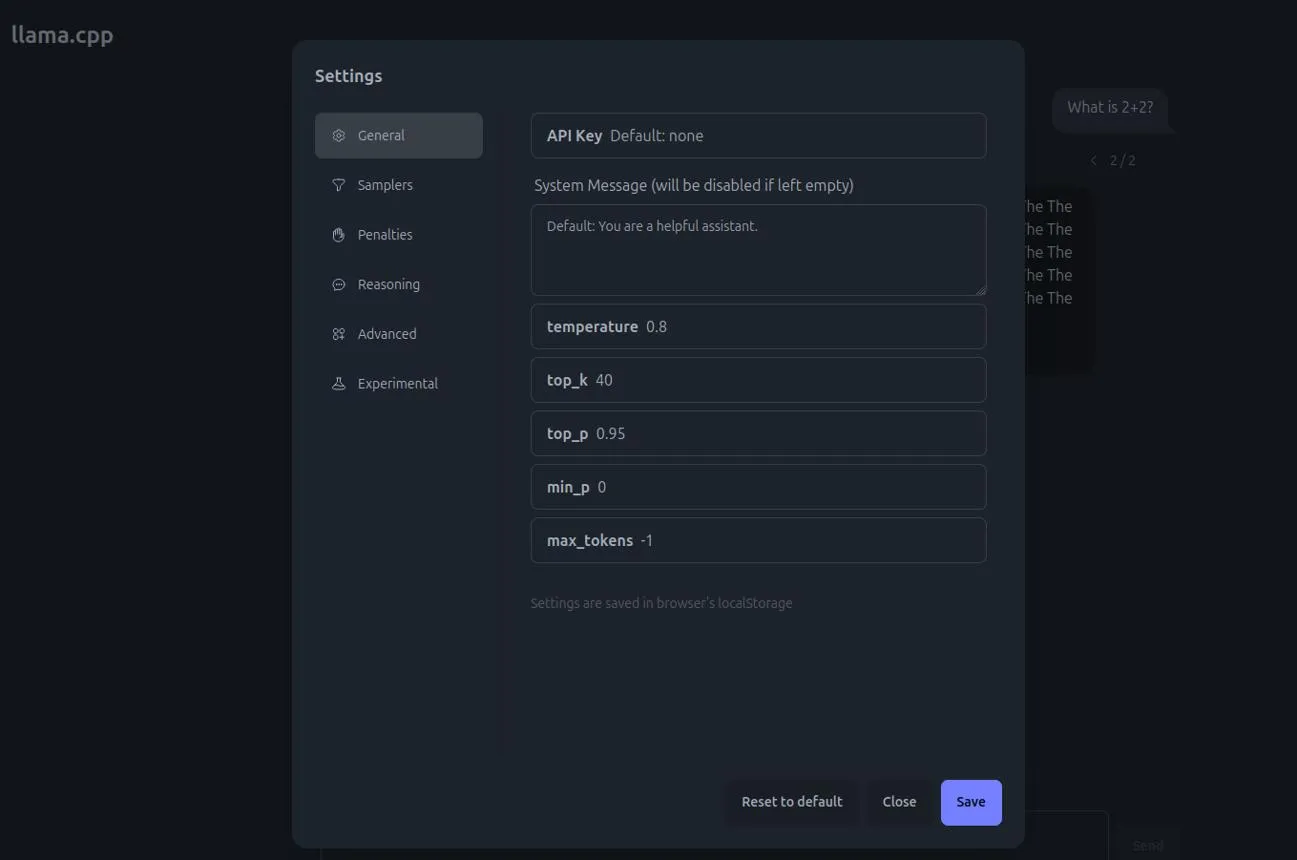
همچنین در llama.cpp میتوانید پارامترهایی مانند top_k و top_p را از طریق رابط یا تنظیمات اجرای مدل تغییر دهید. این پارامترها بر شیوه انتخاب توکن بعدی اثر میگذارند و ممکن است تنوع پاسخها را تغییر دهند؛ با این حال، تنظیم آنها بهتنهایی تضمین نمیکند که پاسخها دقیقتر شوند.
Ollama یا llama.cpp؛ کدام را انتخاب کنیم؟
اگر اولویت شما اجرای سریع و ساده مدلهای هوش مصنوعی است و نمیخواهید درگیر پارامترهای فنی شوید، Ollama انتخاب مناسبی است. اما اگر از مدلهای بزرگ استفاده میکنید، میخواهید مصرف حافظه را دقیقتر مدیریت کنید یا به دنبال تنظیمات بیشتر برای اجرای مدل روی GPU هستید، llama.cpp ارزش امتحان کردن دارد.
پیش از مهاجرت، بهتر است یک مدل یکسان را در هر دو ابزار اجرا کنید و سرعت تولید توکن، مصرف رم و حافظه گرافیکی و کیفیت پاسخها را بسنجید. همچنین توجه داشته باشید که تنظیمات بهینه برای یک مدل الزاماً برای مدل دیگر بهترین نتیجه را نمیدهند.
در نهایت، لازم نیست انتخاب شما همیشگی باشد. میتوانید Ollama را برای استفاده روزمره نگه دارید و از llama.cpp برای آزمایشهای فنی و مقایسه عملکرد استفاده کنید. مهمترین معیار، نتیجهای است که روی سختافزار خودتان میگیرید.
سادهگو