مدلهای هوش مصنوعی محلی معمولاً برای اجرا به حافظه گرافیکی زیادی نیاز دارند و همین موضوع باعث میشود کاربران دارای کارت گرافیک با ۸ گیگابایت VRAM نتوانند بسیاری از مدلهای بزرگ را بهراحتی اجرا کنند. با این حال، مدل Bonsai 27B با فشردهسازی بسیار شدید وزنها تلاش میکند قابلیتهای یک مدل ۲۷ میلیارد پارامتری را به سختافزاری با حافظه محدود بیاورد. نسخهای از این مدل با فایل حدود ۴٫۴ گیگابایتی عرضه شده که حتی فایلهای مربوط به پردازش تصویر را نیز در خود دارد!
این مدل بر پایه Qwen3.6 27B ساخته شده و برای اجرای محلی طراحی شده است؛ بنابراین برای استفاده از آن لزوماً به سرویس ابری نیاز ندارید. البته حجم کم فایل به این معنی نیست که تمام قابلیتهای مدل بدون محدودیت اجرا میشوند. مقدار حافظه موردنیاز به طول گفتگو، تنظیمات و برنامه اجراکننده بستگی دارد و فشردهسازی نیز میتواند دقت بعضی وظایف را کاهش دهد.
مدل Bonsai 27B چیست و چگونه روی کارت گرافیک ۸ گیگابایتی اجرا میشود؟
Bonsai 27B محصول شرکت PrismML است و از مدل Qwen3.6 27B بهعنوان پایه استفاده میکند. تفاوت اصلی آن با نسخه معمولی، روش ذخیرهسازی وزنهای مدل است. در نسخه یکبیتی، وزنها بهصورت مقادیر مثبت یک یا منفی یک ذخیره میشوند و هر گروه از ۱۲۸ وزن، یک ضریب مقیاس مشترک دارد. در نتیجه، حجم ذخیرهسازی به حدود ۱٫۱۲۵ بیت برای هر وزن میرسد.
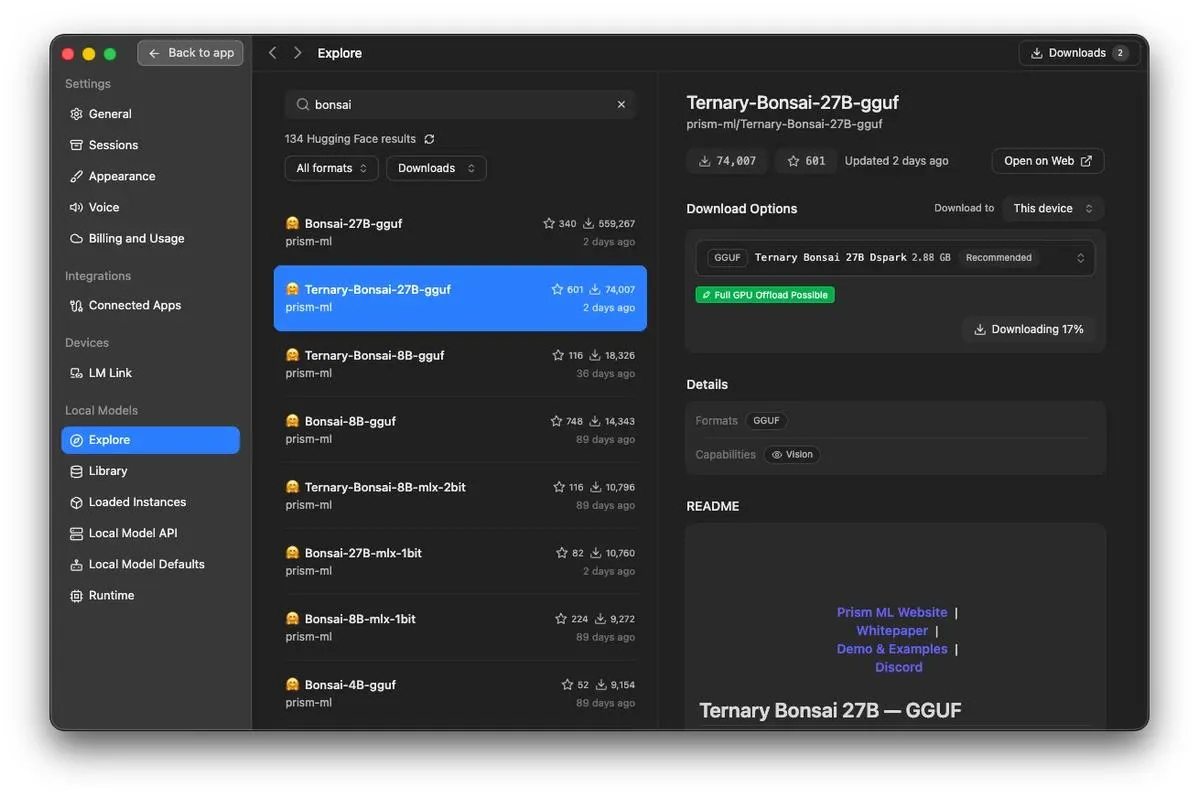
نسخه یکبیتی مورد اشاره، همراه با فایلهای بینایی، حدود ۴٫۴ گیگابایت حجم دارد و در LM Studio قابل انتخاب است. نسخه جدیدتر Bonsai 2 نیز از نمایش سهحالته وزنها استفاده میکند که مقدار صفر را هم در کنار مثبت یک و منفی یک قرار میدهد؛ اما سازگاری آن به برنامه اجراکننده بستگی دارد و ممکن است در برخی ابزارها هنوز قابل استفاده نباشد.
نکته مهم این است که حجم فایل با حافظه موردنیاز هنگام اجرا یکسان نیست. Bonsai از پنجره متنی بسیار بزرگی تا ۲۶۲ هزار توکن پشتیبانی میکند، اما استفاده از کل این ظرفیت میتواند حدود ۱۰ گیگابایت حافظه یا بیشتر بخواهد. بنابراین روی کارت گرافیک ۸ گیگابایتی باید طول متن ورودی را محدود کنید و مقداری حافظه هم برای سیستمعامل و برنامههای دیگر کنار بگذارید.
عملکرد Bonsai 27B در ریاضی، استدلال و خلاصهسازی متن
یکی از نقاط قوت گزارششده برای Bonsai 27B، حل مسائل ریاضی و منطقی است. با وجود فشردهسازی شدید، این مدل میتواند ترکیبهای ممکن را بررسی کند و در مسائل چندگزینهای، گزینه مناسب را بر اساس محدودیتهای مسئله انتخاب کند. نتایج اعلامشده از سوی سازنده برای آزمون ریاضی نسخه فشرده ۹۱٫۷ و برای مدل اصلی Qwen3.6 عدد ۹۵٫۳ بوده است؛ این اعداد به آزمون مشخص مربوطاند و بهتنهایی تضمینکننده عملکرد یکسان در همه مسائل نیستند.
در خلاصهسازی اسناد نیز مدل میتواند متنهای نسبتاً طولانی را به شکل فشرده و منظم ارائه کند. پیروی از دستورهای چندبخشی هم از تواناییهای آن است؛ از جمله رعایت محدودیت واژگان یا استفاده از واحد پولی مشخص در متن تولیدشده. این قابلیتها برای افرادی که میخواهند بدون ارسال اسناد به سرویسهای آنلاین، از هوش مصنوعی برای بررسی متن استفاده کنند، مفید است.
با این حال، فشردهسازی میتواند روی تولید کد اثر بگذارد. Bonsai در کارهای برنامهنویسی کوتاه عملکرد قابلقبولی نشان میدهد، اما ممکن است جزئیات مهمی را جا بیندازد؛ به عنوان مثال، برنامهای که برای پایش یک پوشه نوشته شده بود، فایلهای پردازششده را بهدرستی ثبت نمیکرد. بنابراین بهتر است کد تولیدشده را اجرا و بررسی کنید و صرفاً به ظاهر کامل آن اعتماد نکنید.
مقایسه Bonsai 27B با Qwen و Gemma؛ کدام مدل بهتر است؟
با وجود تواناییهای Bonsai، فشردهسازی یکبیتی در همه وظایف نتیجه یکسانی ندارد. طبق بنچمارکهای منتشرشده برای این مدل، امتیاز نسخه یکبیتی در بخش فراخوانی ابزارها ۶۶ بوده، در حالی که نسخه اصلی Qwen3.6 27B امتیاز ۸۰ را کسب کرده است. در آزمونهای بینایی نیز نسخه فشرده امتیاز پایینتری داشته است. این نتایج نشان میدهند که کوچک شدن مدل لزوماً به معنای حفظ تمام تواناییهای آن نیست. در بنچمارکهای مشابه نیز نتایج مشابهی به دست آمده است.
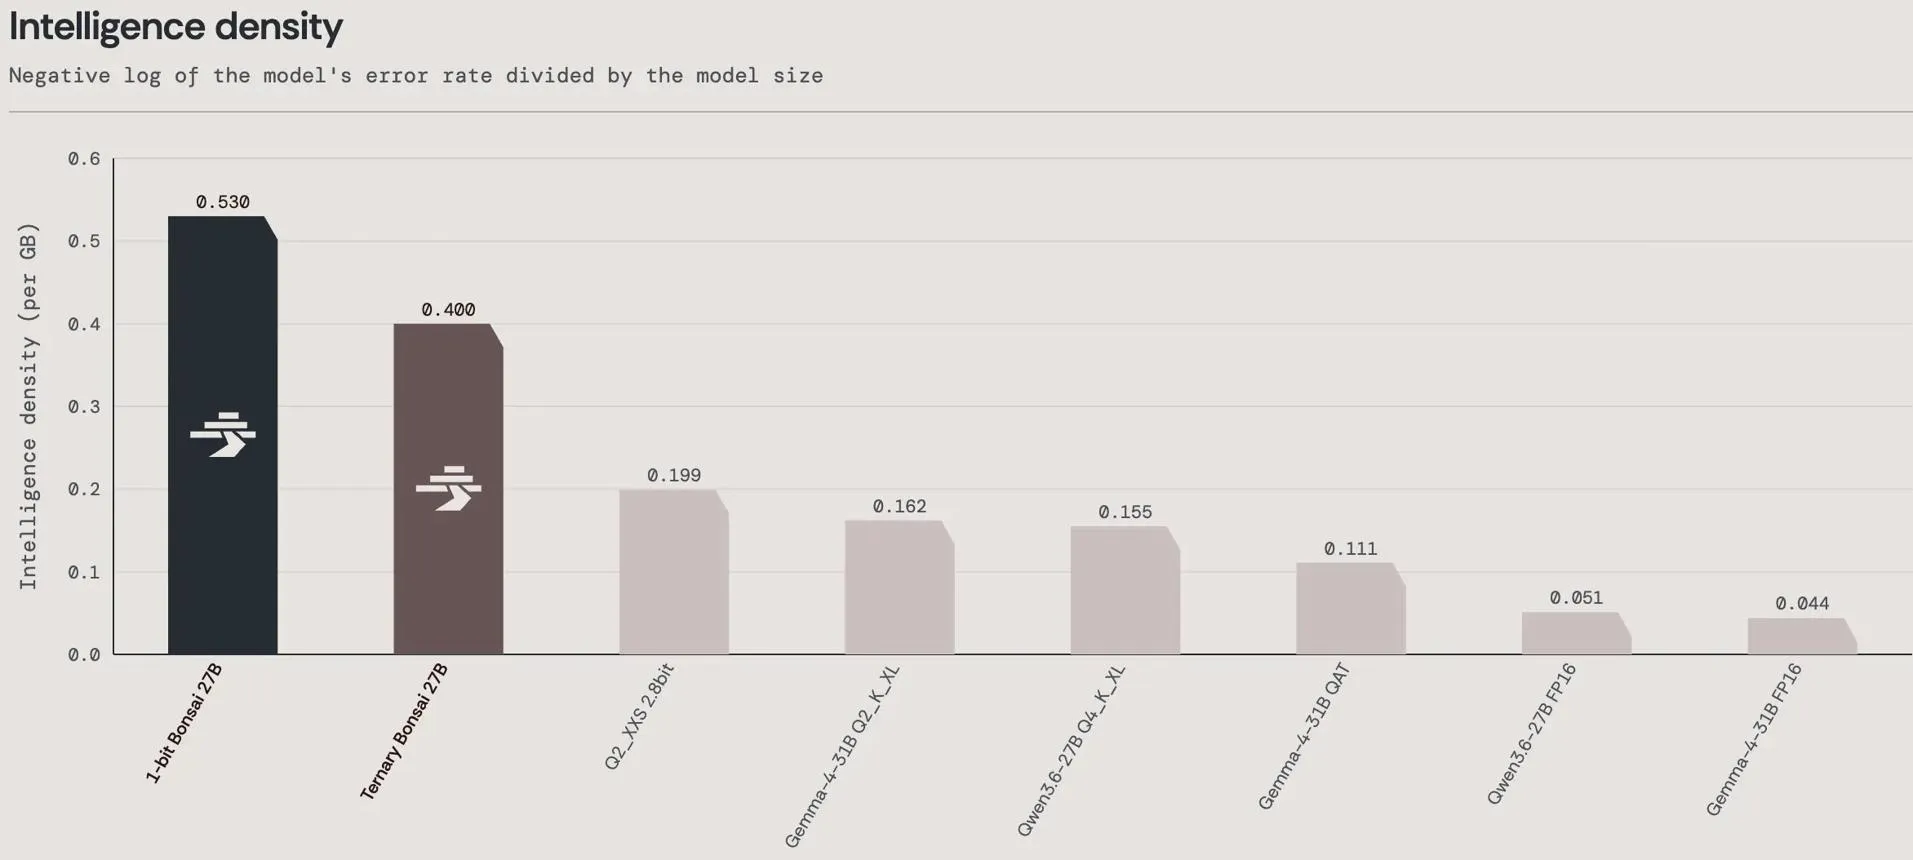
برای انتخاب بین این مدلها میتوان به کاربرد موردنظر توجه کرد:
- Bonsai 27B: مناسب برای آزمایش مدلهای بزرگتر روی سختافزار محدود و انجام کارهای متنی و استدلالی، بهویژه وقتی ظرفیت حافظه اهمیت زیادی دارد.
- Qwen 3.5 9B: انتخاب مناسبتری برای کارهایی است که به فراخوانی ابزارها و اجرای زنجیرهای وظایف وابستهاند؛ البته نتیجه نهایی به نسخه مدل و تنظیمات بستگی دارد.
- Gemma 4 E4B: برای کارهای مرتبط با تصویر و پاسخگویی سریع میتواند گزینه مناسبی باشد.
سرعت اجرا نیز اهمیت دارد. در یک آزمایش با تنظیمات یکسان، Bonsai حدود ۲۷ توکن بر ثانیه و Gemma 4 E4B حدود ۳۵ توکن بر ثانیه تولید کرده است. این اعداد به سختافزار و شرایط همان آزمایش وابستهاند و نباید آنها را سرعت تضمینشده روی همه رایانهها در نظر گرفت.
اجرای مدل Bonsai 27B در LM Studio و تنظیم حافظه
برای استفاده از Bonsai میتوانید از LM Studio و نسخه سازگار مدل در قالب GGUF استفاده کنید. پس از دریافت فایل مناسب، مدل را در برنامه بارگذاری کنید و ابتدا با یک متن کوتاه آن را آزمایش کنید. اگر حافظه گرافیکی یا RAM پر میشود، طول متن ورودی و ظرفیت پنجره زمینه را کاهش دهید.
مسیر دسترسی به مدلها در برنامه ممکن است با توجه به نسخه متفاوت باشد. معمولاً از بخش جستوجوی مدلها میتوانید Bonsai 27B را پیدا و نسخه موردنظر را دریافت کنید.
LM Studio > Discover
LM Studio > کشف مدلها
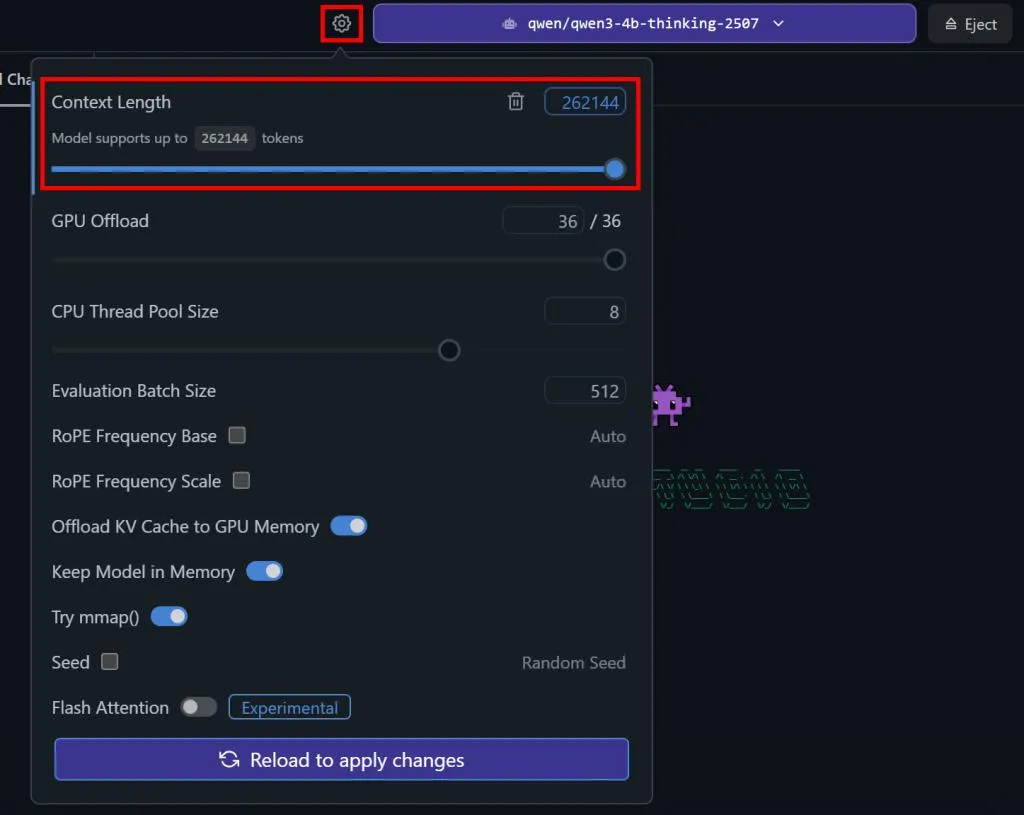
برای تنظیمات حافظه، پس از بارگذاری مدل، گزینههای مربوط به تعداد لایههای پردازشی روی GPU و طول Context را بررسی کنید. نام دقیق گزینهها ممکن است در نسخههای مختلف تفاوت داشته باشد. اگر کارت گرافیک شما ۸ گیگابایت حافظه دارد، از طول زمینه کوتاهتر شروع کنید و فقط در صورت باقی ماندن حافظه کافی آن را افزایش دهید.
همچنین هنگام ارزیابی سرعت، برنامههای سنگین دیگر را ببندید و مصرف حافظه را بررسی کنید. حجم حدود ۴ گیگابایتی فایل مدل بهتنهایی تضمین نمیکند که مدل در هر تنظیمی کاملاً داخل VRAM جا شود؛ حافظه مربوط به پردازش تصویر، بافرها و متن گفتگو نیز باید در نظر گرفته شود.
در مجموع، Bonsai 27B راهی برای آزمایش مدلهای بزرگ با حافظه محدود است، نه جایگزینی بیقیدوشرط برای همه مدلهای کوچکتر. اگر بیشتر با متن، خلاصهسازی و مسائل منطقی سروکار دارید، ارزش امتحان کردن دارد. برای پردازش تصویر یا گردشکارهای وابسته به ابزارها، بهتر است آن را با Qwen و Gemma روی کارهای واقعی خودتان مقایسه کنید.
سادهگو