هوش مصنوعی محلی

چگونه با Ollama و هوش مصنوعی محلی فایل‌های PDF و اسناد خصوصی را تحلیل کنیم؟

اگر تعداد زیادی قبض، فاکتور، صورت‌حساب بانکی، قرارداد و سند پزشکی دارید، پیدا کردن اطلاعات مشخص در میان این فایل‌ها می‌تواند وقت‌گیر باشد. هوش مصنوعی می‌تواند این کار را ساده‌تر کند؛ برای مثال، می‌توانید از آن بخواهید هزینه‌های ماهانه را بررسی کند، بندهای مهم یک قرارداد را توضیح دهد یا اطلاعات یک فایل PDF را خلاصه کند.

با این حال، بارگذاری اسناد حساس در سرویس‌های آنلاین ممکن است نگرانی‌هایی درباره ایجاد کند. یک راه جایگزین، استفاده از هوش مصنوعی محلی است؛ روشی که در آن مدل روی کامپیوتر خودتان اجرا می‌شود و برای پردازش محلی، نیازی به ارسال محتوای اسناد به سرویس ابری ندارد. برنامه Ollama و مدل‌هایی مانند Qwen این امکان را فراهم می‌کنند که بدون خرید یک سیستم گران‌قیمت، تحلیل اسناد را روی کامپیوتر شخصی امتحان کنید.
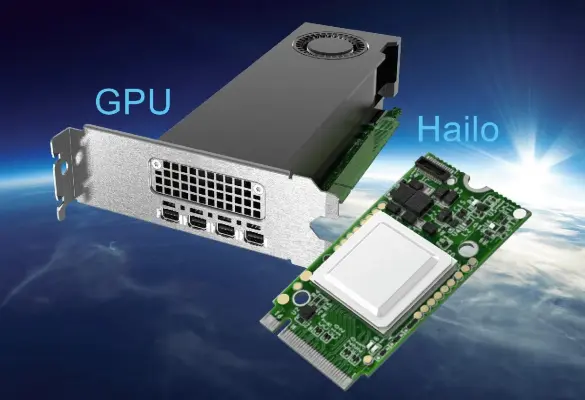
کارت شتاب‌دهنده هوش مصنوعی چیست و آیا بهتر از کارت گرافیک است؟

با گسترش هوش مصنوعی، بسیاری از کاربران برای تنها سخت‌افزار مناسب برای این کار نیست. کارت‌های شتاب‌دهنده هوش مصنوعی نیز وجود دارند که می‌توانند بعضی محاسبات هوش مصنوعی را با مصرف برق بسیار کمتر انجام دهند.

این کارت‌ها معمولاً از طریق اسلات PCIe یا رابط M.2 به سیستم متصل می‌شوند و برخلاف کارت گرافیک، خروجی تصویر ندارند. بااین‌حال، خرید شتاب‌دهنده برای هر کامپیوتری منطقی نیست؛ زیرا نوع مدل، سازگاری نرم‌افزار و محدودیت حافظه تأثیر زیادی بر کاربرد واقعی آن دارند.

اجرای مدل هوش مصنوعی Bonsai 27B روی کارت گرافیک ۸ گیگابایتی؛ مقایسه با Qwen و Gemma

مدل‌های هوش مصنوعی محلی معمولاً برای اجرا به حافظه گرافیکی زیادی نیاز دارند و همین موضوع باعث می‌شود کاربران دارای کارت گرافیک با ۸ گیگابایت VRAM نتوانند بسیاری از مدل‌های بزرگ را به‌راحتی اجرا کنند. با این حال، مدل Bonsai 27B با فشرده‌سازی بسیار شدید وزن‌ها تلاش می‌کند قابلیت‌های یک مدل ۲۷ میلیارد پارامتری را به سخت‌افزاری با حافظه محدود بیاورد. نسخه‌ای از این مدل با فایل حدود ۴٫۴ گیگابایتی عرضه شده که حتی فایل‌های مربوط به پردازش تصویر را نیز در خود دارد!

این مدل بر پایه Qwen3.6 27B ساخته شده و برای اجرای محلی طراحی شده است؛ بنابراین برای استفاده از آن لزوماً به سرویس ابری نیاز ندارید. البته حجم کم فایل به این معنی نیست که تمام قابلیت‌های مدل بدون محدودیت اجرا می‌شوند. مقدار حافظه موردنیاز به طول گفتگو، تنظیمات و برنامه اجراکننده بستگی دارد و فشرده‌سازی نیز می‌تواند دقت بعضی وظایف را کاهش دهد.

هوش مصنوعی محلی یا آنلاین؛ کدام گزینه برای کار و برنامه‌نویسی بهتر است؟

مدل‌های هوش مصنوعی محلی به شما اجازه می‌دهند بدون ارسال مستقیم هر درخواست به سرورهای سرویس‌های آنلاین، از قابلیت‌هایی مانند تولید متن، خلاصه‌سازی و کمک در برنامه‌نویسی استفاده کنید. ابزارهایی مانند LM Studio و Ollama راه‌اندازی این مدل‌ها را ساده‌تر کرده‌اند؛ اما اجرای هوش مصنوعی روی کامپیوتر همیشه به معنای عملکرد بهتر یا بی‌نیازی کامل از سرویس‌های ابری نیست.

انتخاب بین هوش مصنوعی محلی و آنلاین به سخت‌افزار، نوع کار، نیاز به اطلاعات به‌روز و میزان اهمیتی بستگی دارد که برای حریم خصوصی قائل هستید. در بسیاری از کاربردها، ترکیب این دو روش از جایگزین کردن کامل یکی با دیگری منطقی‌تر است.

اصلاح متن با هوش مصنوعی محلی؛ آموزش اجرای LLM با Ollama و Gemma

اگر از نوشتن با کمک هوش مصنوعی استفاده می‌کنید اما نمی‌خواهید خود مدل متن شما را از نو بنویسد، یک مدل زبانی کوچک محلی می‌تواند نقش یک ویراستار ساده را ایفا کند. در این روش، شما متن اصلی را می‌نویسید و مدل فقط غلط‌های تایپی و دستوری یا جمله‌های واقعاً نامفهوم را اصلاح می‌کند.

مزیت مهم این روش این است که متن برای پردازش به سرویس ابری ارسال نمی‌شود. مدل پس از دانلود روی کامپیوتر اجرا می‌شود و می‌توان برای کارهای ساده ویرایش متن از مدل‌های نسبتاً کوچک استفاده کرد. مدل‌های خانواده Gemma نیز در اندازه‌های مختلف عرضه شده‌اند و نسخه‌های کوچک‌تر برای سیستم‌های کم‌مصرف مناسب‌تر هستند.

هوش مصنوعی محلی برای اکسل؛ آموزش تولید VBA و خودکارسازی با LM Studio

یک مدل هوش مصنوعی محلی می‌تواند برای کارهای تکراری اکسل مثل پاک‌سازی داده‌ها، ساخت فرمول و تولید کدهای VBA مفید باشد؛ به‌خصوص زمانی که اطلاعات جدول‌ها محرمانه هستند و نمی‌خواهید آن‌ها را به سرویس‌های ابری ارسال کنید. ابزارهایی مانند LM Studio امکان اجرای مدل‌های زبانی روی خود رایانه را فراهم می‌کنند و پس از دانلود مدل، اجرای گفتگو و پردازش محلی می‌تواند بدون ارسال محتوای واردشده به سرویس ابری انجام شود.

آخرین دیدگاه‌ها
۲۰۰ دیدگاه و پاسخ آخر