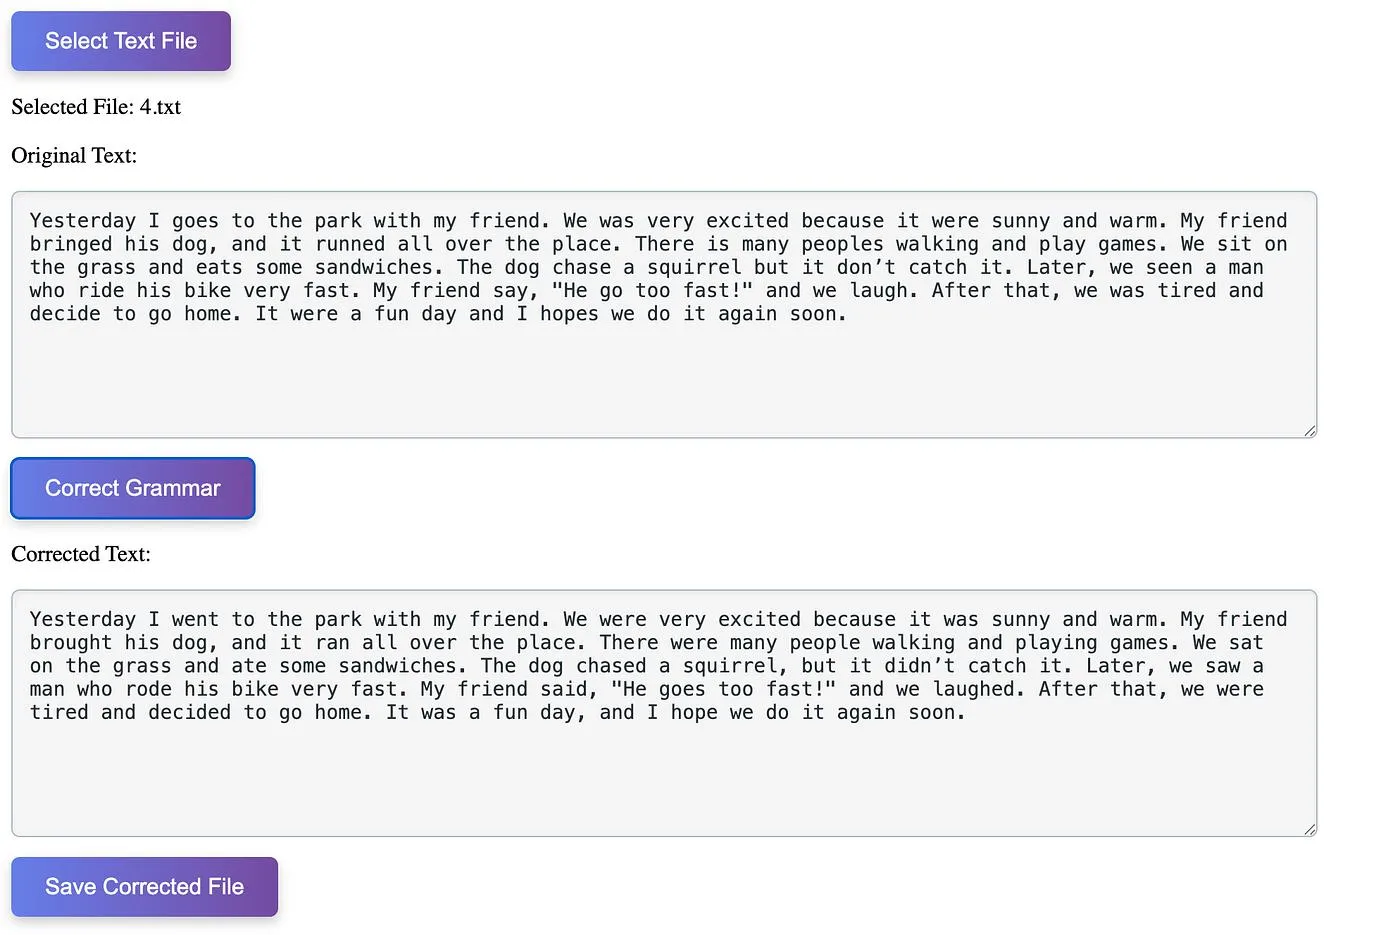
اگر از نوشتن با کمک هوش مصنوعی استفاده میکنید اما نمیخواهید خود مدل متن شما را از نو بنویسد، یک مدل زبانی کوچک محلی میتواند نقش یک ویراستار ساده را ایفا کند. در این روش، شما متن اصلی را مینویسید و مدل فقط غلطهای تایپی و دستوری یا جملههای واقعاً نامفهوم را اصلاح میکند.
مزیت مهم این روش این است که متن برای پردازش به سرویس ابری ارسال نمیشود. مدل پس از دانلود روی کامپیوتر اجرا میشود و میتوان برای کارهای ساده ویرایش متن از مدلهای نسبتاً کوچک استفاده کرد. مدلهای خانواده Gemma نیز در اندازههای مختلف عرضه شدهاند و نسخههای کوچکتر برای سیستمهای کممصرف مناسبتر هستند.
چرا بهتر است هوش مصنوعی فقط متن شما را ویرایش کند؟
یکی از مشکلات استفاده مستقیم از ابزارهای هوش مصنوعی برای نوشتن این است که مدل معمولاً تلاش میکند متن را «بهتر» کند؛ اما بهتر شدن از دید مدل الزاماً به معنی حفظ سبک نویسنده نیست. ممکن است جملهای که عمداً کوتاه نوشتهاید طولانیتر شود یا لحن شخصی متن به یک نوشته رسمی و یکنواخت تبدیل شود.
برای بسیاری از نویسندگان، بخش مهمی از کار دقیقاً در همین بازنویسیهای دستی شکل میگیرد. انتخاب یک واژه، تغییر ترتیب جمله یا حذف یک عبارت اضافی چیزی است که به سبک شخصی نویسنده مربوط میشود.
بنابراین بهتر است از مدل محلی بخواهید ویراستار باشد، نه نویسنده. یعنی فقط زمانی تغییر ایجاد کند که اشتباه مشخصی وجود داشته باشد و در سایر موارد متن اصلی را دستنخورده باقی بگذارد.
این روش با قابلیتهای امروزی مدلهای کوچک نیز سازگار است. برای یک کار محدود مانند بررسی دستور زبان و غلطهای تایپی، الزاماً به یک مدل بسیار بزرگ نیاز ندارید. حتی ابزارهای اختصاصی و سبک برای Proofreading نیز با مدلهای کوچک طراحی شدهاند. به عنوان مثال گوگل یک مدل اختصاصی ۲۰۰ میلیون پارامتری برای اصلاح غلطهای املایی و دستوری ارائه کرده که برای پردازش روی دستگاه طراحی شده است.
بهترین پرامپت برای اصلاح جزئی متن با مدل محلی
مهمترین بخش این روش، پرامپت است. اگر از مدل بخواهید «متن را بهتر کن»، احتمال زیادی وجود دارد که جملهبندیها را تغییر دهد. در عوض باید دقیقاً مشخص کنید که تغییرات باید حداقلی باشند.
میتوانید از این پرامپت استفاده کنید:
این متن را فقط در حد بسیار جزئی ویرایش کن. فقط غلطهای تایپی و دستوری را اصلاح کن و اگر جملهای واقعاً نامفهوم یا ناهماهنگ است، آن را با کمترین تغییر اصلاح کن. جملهها را صرفاً به این دلیل که میتوانند بهتر نوشته شوند بازنویسی نکن. لحن، سبک نوشتار، ساختار، ترتیب جملهها و انتخاب واژههای نویسنده را حفظ کن. هیچ جملهای را با جمله دیگر ترکیب نکن. هیچ اطلاعاتی به متن اضافه نکن. اگر بخشی از متن از نظر نگارشی صحیح است، آن را تغییر نده. نسخه نهایی باید تا حد ممکن به متن اصلی نزدیک باشد.
این نوع دستور بهجای درخواست بازنویسی، یک محدوده مشخص برای مدل تعیین میکند. چنین روشی برای کارهای محدود مانند اصلاح متن مناسبتر است، چون مدل مجبور نمیشود برای هر جمله پیشنهاد جدیدی ارائه کند.
برای متنهای طولانی نیز بهتر است نوشته را در بخشهای کوچکتر پردازش کنید. تقسیم متن به بخشهای منطقی میتواند احتمال تغییر ناخواسته ساختار یا از دست رفتن ارتباط میان جملهها را کمتر کند. ابزارهای محلی Proofreading نیز معمولاً برای متنهای طولانی از پردازش بخشبندیشده استفاده میکنند.
چگونه با Ollama یک ویراستار هوش مصنوعی محلی بسازیم؟
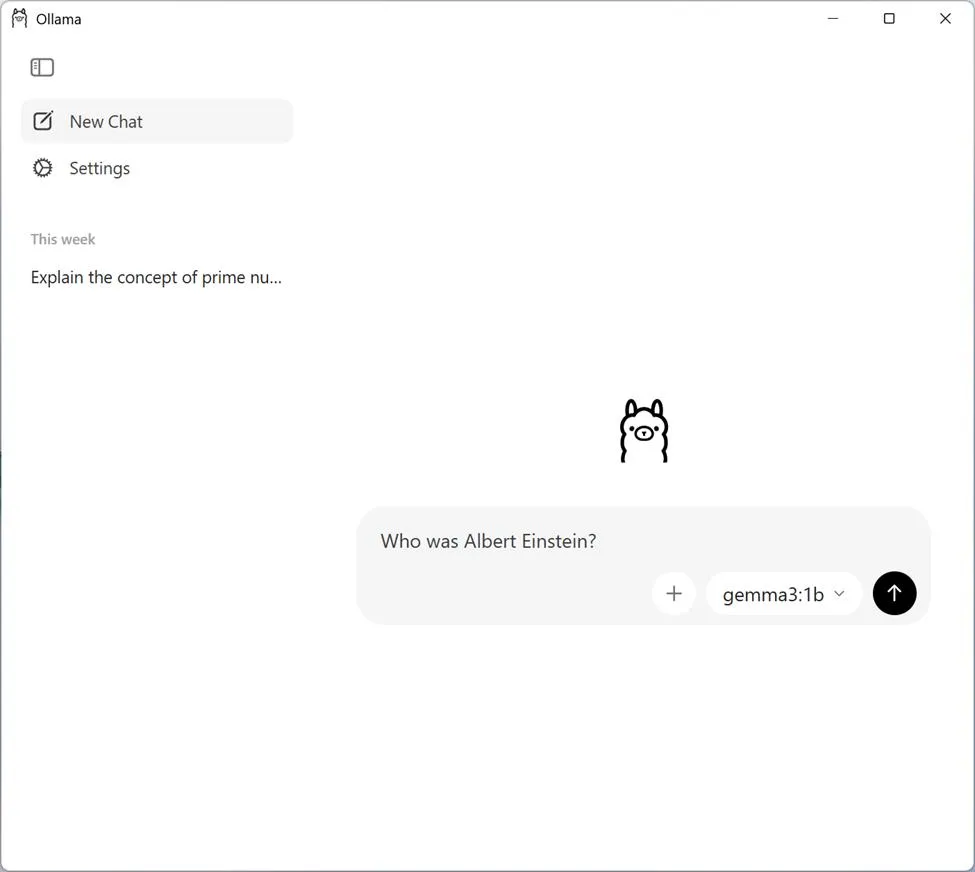
یکی از سادهترین روشها استفاده از Ollama و یک مدل کوچک است. Ollama امکان اجرای مدلهای مختلف را بهصورت محلی فراهم میکند و خانواده Gemma نیز در کتابخانه آن نسخههایی از ۱ میلیارد تا ۲۷ میلیارد پارامتر دارد. نسخه ۴B برای کارهای عمومی سبک گزینهای متعادل است و حجم مدل آن در نسخه رایج کوانتایزشده حدود ۳.۳ گیگابایت است.
بعد از نصب Ollama، میتوانید مدل مناسب را دریافت کنید. به عنوان مثال برای دریافت نسخه ۴B خانواده Gemma میتوانید دستور زیر را در ترمینال اجرا کنید:
ollama run gemma3:4b
پس از اجرای مدل، متن خود را همراه با پرامپت اصلاح متن در اختیار آن قرار دهید. برای این نوع کار بهتر است دمای مدل پایین باشد تا پاسخها کمتر خلاقانه و قابل پیشبینیتر باشند.
اگر سیستم شما حافظه محدودی دارد، میتوانید مدل کوچکتر را انتخاب کنید. نسخه ۱B خانواده Gemma در کتابخانه Ollama حدود ۸۱۵ مگابایت حجم دارد و برای کارهای ساده فشار بسیار کمتری به سیستم وارد میکند. در مقابل، مدل ۴B معمولاً توانایی بیشتری برای درک متن و دستورهای پیچیدهتر دارد.
مسیر اجرای مدل در Ollama:
Ollama > Run Model > gemma3:4b
اگر از رابطهای گرافیکی مانند Open WebUI استفاده کنید، دیگر لازم نیست متن و پرامپت را هر بار در ترمینال وارد کنید. مدل محلی به رابط متصل میشود و محیطی شبیه یک چت معمولی در اختیار شما قرار میگیرد.
آیا مدل محلی برای ویرایش متن از Grammarly بهتر است؟
هدف این دو روش کاملاً یکسان نیست. Grammarly و ابزارهای مشابه برای ارائه پیشنهادهای لحظهای در محیطهای مختلف طراحی شدهاند و میتوانند هنگام تایپ، مشکلات متن را شناسایی کنند. در مقابل، استفاده از یک LLM محلی انعطاف بیشتری در تعریف دقیق نوع ویرایش به شما میدهد. Grammarly نیز همچنان قابلیتهای گستردهای برای کار در برنامههای مختلف و مرورگر ارائه میکند.
اگر فقط میخواهید غلطهای تایپی را بهصورت خودکار هنگام نوشتن پیدا کنید، یک Grammar Checker اختصاصی میتواند سریعتر و راحتتر باشد. اما اگر میخواهید به مدل بگویید «فقط جملههای واقعاً نامفهوم را اصلاح کن و به سبک من دست نزن»، LLM محلی کنترل بیشتری در اختیار شما میگذارد.
از طرف دیگر، استفاده محلی یک مزیت مهم برای متنهای حساس دارد. وقتی مدل روی کامپیوتر اجرا میشود، متن برای پردازش به سرور یک شرکت ارسال نمیشود. البته باید توجه کنید که محلی بودن مدل بهتنهایی تضمین نمیکند هیچ دادهای از سیستم خارج نشود؛ برنامهای که برای رابط یا دریافت مدل استفاده میکنید ممکن است هنگام دانلود یا بهروزرسانی با اینترنت ارتباط داشته باشد.
برای متنهای محرمانه بهتر است پس از دانلود مدل، دسترسی شبکه برنامههای مورد استفاده را نیز بررسی کنید و مطمئن شوید متن از طریق یک سرویس ابری پردازش نمیشود.
برای ویرایش متن به چه سختافزاری نیاز داریم؟
برای Proofreading ساده، نیازی به کارت گرافیک قدرتمند یا مدلهای بسیار بزرگ ندارید. مدلهای کوچکتر میتوانند با حافظه رم کمتر و حتی روی CPU اجرا شوند، هرچند سرعت پاسخ به سختافزار بستگی دارد.
اگر کامپیوتر شما ۸ گیگابایت رم دارد، مدلهای کوچکتر انتخاب منطقیتری هستند. در سیستمهای ۱۶ گیگابایتی میتوانید سراغ مدلهای ۴B و مدلهای مشابه بروید و اگر کارت گرافیک با VRAM کافی دارید، اجرای مدل روی GPU سرعت پاسخ را بیشتر میکند.
نکته مهم این است که برای اصلاح یک متن معمولی، افزایش اندازه مدل همیشه نتیجه بهتری ایجاد نمیکند. در این کار، پرامپت دقیق و مدل مناسب اهمیت زیادی دارد. حتی مدلهای کوچک میتوانند برای اصلاحات محدود عملکرد قابل قبولی داشته باشند، در حالی که مدل بزرگتر ممکن است با وجود توانایی بیشتر، همچنان تمایل داشته باشد متن را بیش از حد بازنویسی کند.
در نهایت، اگر از تغییر لحن و بازنویسی بیش از حد توسط ابزارهای هوش مصنوعی ناراضی هستید، لازم نیست استفاده از AI را کاملاً کنار بگذارید. میتوانید مدل محلی را به یک ویراستار کمدخالت تبدیل کنید؛ مدلی که فقط اشتباههای مشخص را پیدا کند و نوشتهای که خودتان با دقت نوشتهاید، همچنان نوشته خودتان باقی بماند.
سادهگو